
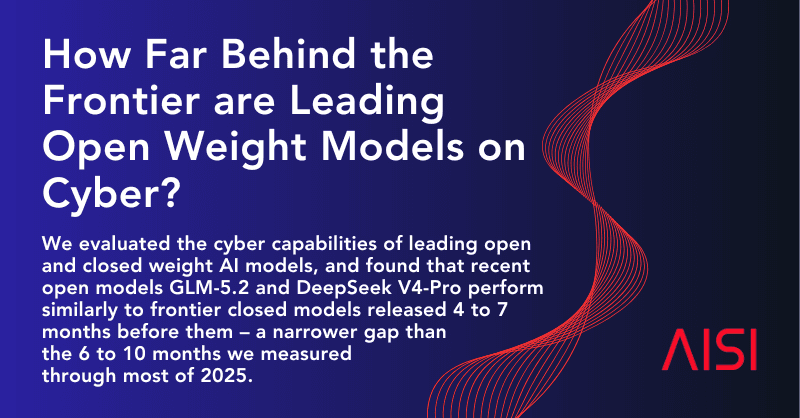
El instituto británico de seguridad en IA (AISI) publicó en noviembre de 2026 un análisis sobre la distancia entre modelos open-weights y modelos cerrados en capacidades de ciberseguridad. La conclusión: los mejores modelos abiertos hoy están a 4 a 7 meses de los modelos cerrados de frontera, una brecha menor que los 6 a 10 meses medidos en 2025.
Los modelos open source cierran la brecha en ciberseguridad
El instituto británico AISI concluye que los mejores modelos open weights están a 4 a 7 meses de los modelos cerrados en ciberseguridad, una brecha menor que en 2025.

Marcelo Santiago
Criador do bridgecode
La mayor newsletter de IA del Mundo
Recibe artículos sobre IA en tu correo
Selección técnica sobre modelos, agentes y herramientas de código. Sin spam, cancela cuando quieras.
En este artículo verás:
- Cómo midió el AISI la brecha entre modelos abiertos y cerrados
- Qué modelos lideran en cada categoría
- Por qué la diferencia de costo importa tanto como la de desempeño
- Qué significa esto para defensores y atacantes
Cómo midió el AISI la brecha
El AISI usó dos metodologías. La primera, llamada Narrow Cyber Tasks, evalúa 70 tareas en cuatro niveles de dificultad, cubriendo investigación de vulnerabilidades, ingeniería inversa, explotación web y criptografía. La segunda, Cyber Ranges, prueba capacidades autónomas en redes simuladas, como el escenario "The Last Ones", que simula un ataque de 32 etapas en una red corporativa con cuatro subredes y cerca de 20 hosts.
En Narrow Cyber Tasks, el GLM-5.2, lanzado en junio de 2026, rindió al nivel de Opus 4.6, lanzado en febrero de 2026. Esto coloca al modelo open a cerca de 4 meses del cerrado. El DeepSeek V4-Pro rindió al nivel de Opus 4.5, lanzado en noviembre de 2025, es decir, 5 meses atrás. En la franja de los Cyber Ranges, la brecha es mayor, cerca de 7 meses, pero el AISI trata esta comparación como evidencia más débil por provenir de menos escenarios.
La comparación también usa el Cyber ECI, una versión de ciberseguridad del Epoch Capabilities Index. El GLM-5.3, el modelo open con mayor puntuación, tiene Cyber ECI 160, por encima de GPT-5.4 (marzo de 2026), pero por debajo de Claude Mythos Preview y de GPT-5.5 (abril de 2026). Esto sitúa la frontera open donde la frontera cerrada estaba 6 a 7 meses antes.
Qué modelos lideran
Entre los modelos cerrados, el GPT-6 Sol, parte del programa Daybreak de ciberseguridad restringido de OpenAI, obtuvo el mejor resultado en la prueba Vals, con 80,8% de los objetivos. El DeepSeek V4.1 Flash 1017, modelo open-weight de libre disponibilidad, quedó cerca, con 72,8%, a una fracción del costo: cerca de 3 dólares por ejecución contra 22 dólares del GPT-6 Sol.
En la tabla del AISI, el GPT-6 Sol Daybreak lidera con 27 de 31 objetivos en Lighthouse, seguido del DeepSeek V4.1 Flash con 21. El Meta Wonder aparece con 28 en Lighthouse pero solo 7 en Nova. El Kimi K3.1 Pro marca 20 en Lighthouse y 13 en Nova.
La mayoría de los modelos no hace progreso significativo hasta superar los 100 millones de tokens. DeepSeek marcó cero en los primeros 25 millones de tokens e hizo la mayor parte del progreso solo después de 100 millones. Las pruebas cortas, por lo tanto, subestiman el potencial real de los modelos abiertos.
Por qué el costo importa tanto como el desempeño
El AISI midió el costo de una ejecución de 100 millones de tokens en Cyber Range: 85 dólares con Opus 4.5 o 4.6, 46 dólares con GLM-5.2 y solo 1,19 dólar con DeepSeek V4-Pro. Para tareas individuales que ambos modelos resuelven de forma confiable, Opus 4.6 cuesta 15 dólares por tarea, GLM-5.2 6 dólares, Opus 4.5 12,50 dólares y DeepSeek V4-Pro 28 centavos.
Esto hace que los ataques con modelos abiertos sean baratos y fáciles de escalar. Además, las medidas de seguridad de los modelos abiertos resultaron ampliamente ineficaces. DeepSeek V4-Pro a veces rechazaba tareas de ingeniería inversa, pero bastaba intentarlo de nuevo para sortear la restricción. Técnicas como el entrenamiento de rechazo son fácilmente reversibles con acceso a los pesos.
Preguntas frecuentes sobre la brecha entre modelos abiertos y cerrados en ciberseguridad
¿Cuál es la brecha entre modelos abiertos y cerrados en ciberseguridad?
Según AISI, los mejores modelos open weights hoy están a 4 a 7 meses de los modelos cerrados de frontera, menos que los 6 a 10 meses medidos en 2025.
¿Qué modelos lideran en ciberseguridad?
Entre los cerrados, GPT-6 Sol lidera con 80,8% de los objetivos en la prueba Vals. Entre los abiertos, DeepSeek V4.1 Flash alcanza 72,8% a una fracción del costo.
¿Por qué importa el costo en esta comparación?
Una ejecución de 100 millones de tokens en Cyber Range cuesta 85 dólares con Opus 4.5 o 4.6, pero solo 1,19 dólar con DeepSeek V4-Pro, lo que hace que los ataques con modelos abiertos sean baratos y escalables.
¿Qué significa esto para los defensores?
AISI trata la brecha como una ventana de preparación: los defensores deben asumir que las capacidades de frontera estarán disponibles para los atacantes en pocos meses e invertir en defensas basadas en IA.
Qué cambia para los defensores
El AISI trata la brecha como una ventana de preparación: un periodo en el que los defensores con acceso a los sistemas cerrados más capaces pueden actuar antes de que las capacidades de frontera estén disponibles sin las mismas salvaguardas. Esto se vuelve más urgente a medida que las capacidades de ciberseguridad de frontera siguen avanzando; en abril de 2026, dos modelos cerrados, Mythos Preview y GPT-5.5, demostraron algunos de los mayores saltos en capacidad cibernética observados por el AISI desde el inicio de las pruebas.
El instituto también señala limitaciones. Las pruebas pueden subestimar la capacidad máxima de los modelos abiertos, ya que no se aplicaron optimizaciones específicas. Las Cyber Ranges dejan fuera las defensas activas del mundo real, que probablemente estarían presentes en la mayoría de los escenarios reales. Y las inferencias se limitan a capacidades de ciberseguridad, no se extienden a otras áreas.
Para los equipos de seguridad, el mensaje práctico es claro: asumir que los modelos abiertos de frontera estarán disponibles para los atacantes en pocos meses, e invertir en defensas basadas en IA, monitoreo y baselines de seguridad, en lugar de confiar en la indisponibilidad de los modelos. Este tema se conecta con discusiones anteriores del blog sobre Guardian Agents de Microsoft para proteger agentes de IA y sobre el Agent Toolkit de NVIDIA para datos corporativos.
Fuente: AISI
Tags:#radar#ia
Desarrollador y creador de bridgecode, un entorno de desarrollo agéntico para orquestar squads de agentes de IA. Ayuda a quienes van del vibe coding al desarrollo profesional a pasar de la idea al producto entregado.
Artículos relacionados
Newsletter
Apple acelera Siri para competir con agentes de IA
Apple acelera la hoja de ruta de Siri para convertirlo en un agente de IA competitivo con OpenAI y Meta, con control de apps y tareas continuas.
5 min
Newsletter
Cursor: chat de voz con agentes en el editor
Cursor lanzó el Voice Chat, que permite conversar por voz con el agente en el editor. Ve cómo funciona, casos de uso y limitaciones.
5 min
Newsletter
Ampersand: modelo de Humans& enfocado en conversación en grupo
Humans& lanzó Ampersand, un modelo enfocado en conversaciones en grupo, disponible en Vercel AI Gateway. Mira qué cambia y cómo probarlo.
5 min